

AI merupakan singkatan dari artificial intelligence atau kecerdasan buatan.
Analisis strategis | 24 Oktober 2026. Tulisan ini mengusulkan kerangka evaluasi untuk keputusan organisasi, bukan peringkat model terkini. Pertanyaan strategisnya bukan siapa paling cerdas secara umum, melainkan bukti apa yang cukup untuk memberikan kewenangan tertentu kepada sistem AI.
Pisahkan kemampuan dari izin bertindak
Dalam penjelasan HELM yang diterbitkan Stanford CRFM pada 17 November 2022, evaluasi holistik memiliki tiga unsur: cakupan luas dengan pengakuan atas kekurangan, pengukuran banyak metrik, dan standardisasi perbandingan.[3] Prinsip tersebut berguna sebagai titik awal, bukan sebagai bukti bahwa model tertentu layak dipasang pada pekerjaan berbahasa Indonesia hari ini.
Analisis saya membedakan tiga pertanyaan: apakah model dapat menghasilkan jawaban, apakah sistem dapat menyelesaikan pekerjaan, dan apakah organisasi seharusnya mengizinkannya bertindak. Ketiganya memerlukan bukti berbeda. Kemampuan menyusun ringkasan, misalnya, tidak dengan sendirinya menjadi alasan memberi akses untuk mengubah catatan pelanggan.
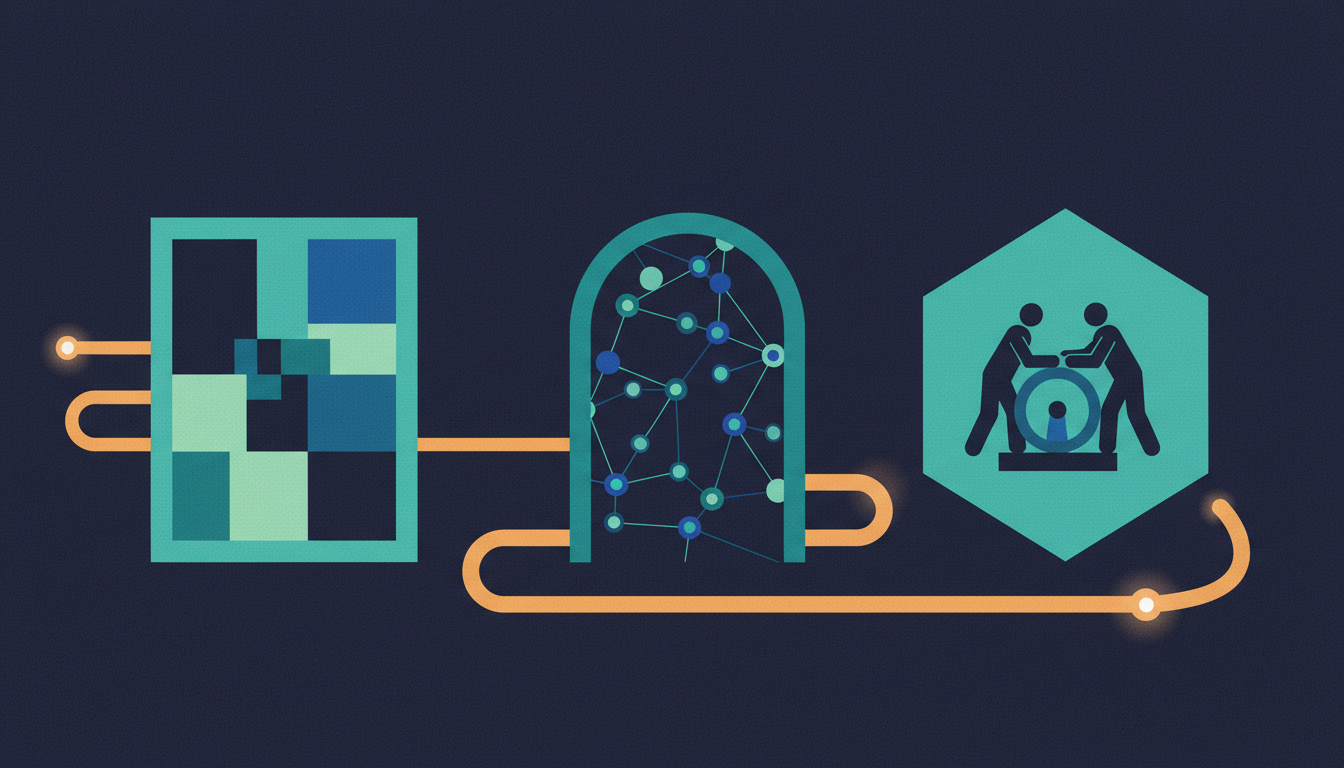
Kerangka tiga gerbang keputusan
Gerbang pertama adalah kesesuaian tugas. Definisikan unit pekerjaan sebelum memilih model: masukan apa yang tersedia, keluaran apa yang diperlukan, dan kesalahan apa yang tidak dapat diterima. Untuk pencarian kebijakan internal, jawaban yang lancar belum cukup; dalam rancangan evaluasi ini, penilai harus dapat mencocokkannya dengan dokumen yang berlaku.
Bangun kumpulan kasus dari pekerjaan yang benar-benar ingin dilayani, dengan izin dan perlindungan data yang sesuai. Sertakan pertanyaan tidak lengkap, istilah lokal, dokumen yang saling bertentangan, serta permintaan di luar cakupan. Pisahkan kasus pengembangan instruksi dari kasus penilaian akhir. Tujuannya adalah mengurangi peluang tim sekadar menyempurnakan jawaban untuk contoh yang sudah dikenal.
Gerbang kedua adalah ketahanan sistem. Uji rangkaian lengkap yang akan digunakan: pencarian dokumen, instruksi, model, alat, dan pemeriksaan keluaran. Jika aplikasi dimaksudkan hanya membaca informasi, sediakan kasus yang mencoba mendorongnya melakukan perubahan. Rekomendasi ini adalah rancangan pengujian, bukan klaim bahwa seluruh aplikasi memiliki kelemahan yang sama.
Gerbang ketiga adalah kewenangan. Tetapkan tindakan mana yang memerlukan persetujuan manusia, kapan sistem harus menolak, dan siapa yang menangani pengecualian. Jangan merata-ratakan kesalahan kritis bersama kesalahan kosmetik. Organisasi dapat menerima kekurangan gaya bahasa sambil tetap menolak setiap perubahan data tanpa izin.
Ukur keputusan, bukan hanya jawaban
HELM menekankan bahwa banyak metrik perlu diperiksa pada konteks penggunaan yang sama agar pertukaran antarkualitas terlihat.[3] Untuk penerapan organisasi, saya mengusulkan kartu penilaian yang memisahkan ketepatan isi, dukungan sumber, waktu penyelesaian, biaya peninjauan, dan kepatuhan batas kewenangan.
Bandingkan sistem AI dengan proses tanpa AI yang benar-benar tersedia. Mintalah penilai memeriksa hasil tanpa melihat nama model bila memungkinkan. Catat ketidaksepakatan penilai dan revisi kriteria jika sebuah keluaran tidak dapat dinilai konsisten. Penghematan waktu sebaiknya dihitung setelah koreksi, bukan hanya sampai draf pertama muncul.
Sebagai ilustrasi hipotetis, dua sistem bisa sama-sama menghasilkan draf yang dianggap benar, tetapi hanya satu yang menyatakan bahwa bukti tidak cukup. Untuk tugas yang menuntut sumber, saya akan memberi bobot tersendiri pada kemampuan menahan jawaban. Ini pilihan desain evaluasi, bukan hasil eksperimen yang telah dilakukan untuk artikel ini.
Kelulusan memiliki batas waktu
NIST AI RMF 1.0 menganjurkan pengujian sebelum penerapan dan secara berkala ketika sistem beroperasi. Bagian MEASURE juga meminta dokumentasi perangkat uji dan evaluasi pada kondisi yang menyerupai penggunaan.[2] Dokumen tersebut adalah rujukan kerangka, bukan sertifikat kelulusan sebuah produk.
Usulan praktisnya: simpan versi instruksi, kumpulan kasus, konfigurasi alat, hasil penilaian, dan keputusan pemberian akses dalam satu catatan rilis. Ulangi pengujian ketika model, dokumen acuan, atau kewenangan berubah. Berikan penanggung jawab operasional hak menunda perluasan jika bukti belum cukup.
Mulailah dengan satu tugas dan satu batas kewenangan yang jelas. Pilih bukti kelulusan sebelum melihat hasil kandidat. Strategi yang saya usulkan bukan mengejar skor tertinggi, melainkan memastikan setiap kenaikan kewenangan dibayar dengan bukti yang relevan, dapat ditinjau, dan dapat diperbarui.
Sources
[2] https://airc.nist.gov/airmf-resources/airmf/5-sec-core
[3] https://crfm.stanford.edu/2022/11/17/helm.html
Baca Juga di AIGEO
Tiga gerbang evaluasi yang dapat dijalankan di perusahaan
Gerbang pertama adalah kinerja model pada dataset acuan. Pengembang perlu mengetahui tingkat kesalahan, sebarannya antarjenis tugas, dan apakah benchmark yang dipakai mewakili pengguna sesungguhnya. Gerbang kedua adalah ketahanan proses: bagaimana model menangani dokumen ambigu, layanan API terputus, informasi kedaluwarsa, serta jawaban yang memerlukan eskalasi manusia. Gerbang ketiga adalah kewenangan bertindak: apakah agen dibolehkan mengirim email, mengubah transaksi, atau menjalankan alat yang berdampak pada pihak lain.
Setiap gerbang memerlukan aturan gugur. Model dengan skor tinggi tidak boleh melewati pengujian bila melanggar kerahasiaan; workflow yang cepat tidak boleh dipakai jika retry menciptakan transaksi ganda; agen yang fasih tidak boleh mendapat kredensial administrator tanpa alasan. Mulailah dari mode baca-saja dan minta persetujuan manusia pada tindakan berisiko.
Gunakan scorecard sederhana berisi akurasi tugas, keberhasilan mematuhi batas akses, waktu pemulihan, biaya per tugas benar dan persentase kasus yang memerlukan tinjauan. Perubahan model atau konektor harus memicu pengujian regresi. Dengan pendekatan berlapis, evaluasi AI berubah dari lomba angka benchmark menjadi pemeriksaan sistem yang bekerja dalam organisasi nyata.
Catatan implementasi dan pengujian tambahan
Sebuah contoh operasional adalah agen dukungan pelanggan. Pada gerbang model, ujilah ketepatan jawaban terhadap katalog dan kebijakan retur. Pada gerbang workflow, jalankan kasus pesanan hilang, data pelanggan tidak lengkap, dan gangguan integrasi agar tidak ada permintaan yang terhapus. Pada gerbang kewenangan, pastikan agen tidak dapat mengubah rekening pengembalian dana atau memberi diskon di luar kebijakan. Aturan gugur untuk privasi dan transaksi perlu dinyatakan sebelum pengujian. Jika agen lulus dua gerbang pertama tetapi gagal pada gerbang ketiga, sistem tetap belum layak produksi. Simpan baseline tanpa AI untuk mengukur apakah solusi benar-benar mengurangi waktu tunggu dan kesalahan petugas. Pendekatan ini lebih berarti daripada hanya memperlihatkan tingkat keberhasilan pada demonstrasi terpilih.



Leave a Reply