

Dalam tulisan ini, AI adalah singkatan dari artificial intelligence, yakni kecerdasan buatan.
Pembahasan ini berfokus pada pertahanan agen AI yang membaca dokumen atau memakai alat kerja. Tujuannya membantu tim menentukan batas akses dan persetujuan sebelum otomatisasi menyentuh data penting, bukan memberikan instruksi eksploitasi.
Fakta: dokumen bukan sumber otorisasi
NCSC Inggris menjelaskan bahwa model bahasa tidak menegakkan batas keamanan antara instruksi dan data di dalam prompt. Pada indirect prompt injection, konten dari luar dapat diproses sebagai instruksi walaupun pembuat konten tidak berinteraksi langsung dengan pengguna agen. NCSC menganjurkan pembatasan tindakan melalui mekanisme deterministik di luar model, bukan hanya menyaring teks yang masuk.[3]
NIST membahas agent hijacking sebagai bentuk indirect prompt injection yang mengalihkan agen dari tugas sah menuju tindakan yang tidak diinginkan. Evaluasinya menekankan pemeriksaan risiko per tugas, pengujian adaptif, dan percobaan berulang. Angka agregat saja tidak cukup menggambarkan perbedaan konsekuensi antarjenis tindakan.[4]
Sumber tersebut mendukung perlunya mengurangi risiko, bukan menjanjikan semua sistem pasti berhasil diserang. Hasil evaluasi pada lingkungan dan model tertentu juga tidak otomatis berlaku untuk setiap produk atau konfigurasi organisasi.[4]
Analisis: pisahkan membaca, mengusulkan, dan menjalankan
Bagian berikut adalah rancangan pertahanan yang diusulkan redaksi. Bayangkan agen membantu merangkum korespondensi vendor. Untuk tugas itu, akses baca terhadap folder terpilih mungkin cukup. Agen tidak perlu sekaligus mempunyai kemampuan mengganti rekening vendor, mengirim pembayaran, dan menghapus arsip. Tentukan kemampuan minimum berdasarkan tugas, bukan berdasarkan seluruh kemampuan platform.
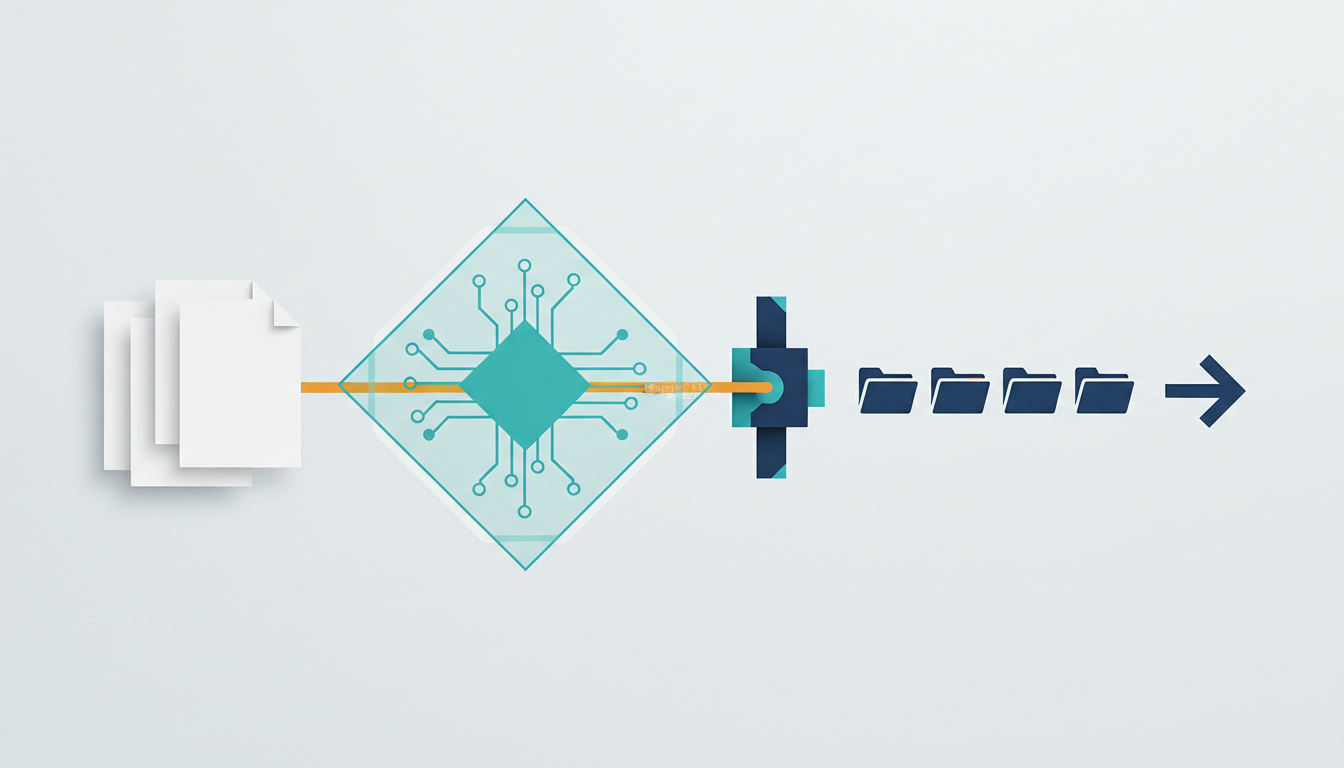
Buat tiga tahap yang berbeda. Tahap pertama membaca bahan dan menghasilkan ringkasan. Tahap kedua menyiapkan usulan tindakan dengan tujuan, penerima, dan data yang akan digunakan. Tahap ketiga menjalankan tindakan hanya setelah pemeriksaan kebijakan. Jika tahap pertama menemukan teks yang meminta hak tambahan, jadikan teks tersebut bahan evaluasi, bukan dasar pemberian akses.
Pemisahan ini merupakan pilihan desain untuk memperkecil dampak kesalahan, bukan sertifikat kebal prompt injection. Tim tetap perlu menilai apakah manfaat agen sepadan dengan risiko yang tersisa pada proses bisnisnya.
Analisis: tegakkan izin di luar model
Tempatkan pemeriksaan izin pada layanan yang benar-benar mengeksekusi tindakan. Layanan tersebut dapat menolak pengiriman kepada penerima di luar daftar yang diizinkan atau perubahan data di luar lingkup tugas. Jangan menjadikan penjelasan model bahwa suatu tindakan “aman” sebagai satu-satunya dasar pemberian izin.
Gunakan identitas layanan khusus untuk setiap peran agen. Sebagai usulan awal, agen peringkas tidak memegang kredensial administrator, sedangkan agen penyiap draf tidak memiliki hak publikasi. Berikan akses berdasarkan proyek dan kebutuhan, lalu cabut ketika tugas selesai. Simpan rahasia di pengelola kredensial, bukan sebagai teks yang ikut dibaca dari dokumen.
Untuk tindakan berdampak besar, hadirkan persetujuan manusia yang spesifik: penerima, isi akhir, berkas yang dilampirkan, serta perubahan yang akan terjadi. Jika salah satu unsur berubah setelah persetujuan, minta persetujuan baru. Tombol konfirmasi yang tidak memperlihatkan tindakan konkret sulit dijadikan kontrol bermakna.
Analisis: uji kegagalan proses, bukan sekadar jawaban
Susun evaluasi terkontrol dengan data sintetis dan akun uji. Periksa apakah agen tetap berada dalam lingkup dokumen yang ditentukan, apakah pengiriman di luar kebijakan ditolak, dan apakah proses berhenti saat persetujuan tidak tersedia. Tidak perlu memakai data pelanggan sungguhan untuk menguji batas-batas tersebut.
Selaras dengan penekanan NIST pada evaluasi per tugas dan berulang, tim dapat mengulangi skenario setelah perubahan model, alat, atau izin. Laporkan hasil setiap kemampuan secara terpisah: akses baca, perubahan dokumen, dan komunikasi keluar. Kelulusan merangkum dokumen tidak boleh dipakai sebagai bukti keamanan mengirim pesan otomatis.[4]
Analisis: siapkan penghentian dan pemulihan
Sediakan cara menonaktifkan identitas agen tanpa menghentikan seluruh layanan. Catat usulan tindakan, keputusan pemeriksaan izin, persetujuan, dan hasil eksekusi. Tetapkan masa simpan serta akses log; hindari menyalin rahasia atau seluruh dokumen sensitif tanpa kebutuhan yang jelas.
Sebelum produksi, tentukan siapa yang menerima alarm, mencabut akses, dan memeriksa perubahan. Keamanan agen bukan perlombaan menyusun kalimat larangan paling panjang. Ukuran yang lebih berguna ialah apakah tindakan di luar mandat tetap ditolak ketika model salah memahami bahan yang dibacanya.
Sources
[3] https://www.ncsc.gov.uk/blog-post/prompt-injection-is-not-sql-injection
[4] https://www.nist.gov/news-events/news/2025/01/technical-blog-strengthening-ai-agent-hijacking-evaluations
Baca Juga di AIGEO
Model ancaman untuk prompt injection pada agen perusahaan
Pertama identifikasi sumber yang boleh memberi perintah. Instruksi pengguna yang terautentikasi dan kebijakan sistem harus dipisahkan dari email, halaman web dan lampiran eksternal yang dibaca agen. Dokumen eksternal adalah bahan tugas, bukan pemegang wewenang. Jika model mencampur keduanya, sebuah kalimat dalam dokumen dapat mencoba mengubah tindakan AI tanpa persetujuan pengguna.
Kedua petakan alat yang dapat dijalankan agen. Batasi hak membaca, menulis, mengirim pesan dan mengubah konfigurasi secara terpisah. Gunakan token berumur pendek, verifikasi tujuan pengiriman, serta approval untuk tindakan bernilai besar atau tak dapat dibatalkan. Kontrol penting harus bekerja pada lapisan server meskipun model memberikan saran yang keliru.
Ketiga bangun pengujian defensif dengan pesan uji yang mencoba mengalihkan tujuan, mengungkap informasi atau memanggil alat terlarang. Ukur apakah broker alat menolak, apakah log menyimpan bukti yang cukup dan apakah operator dapat menghentikan run. NCSC dan OWASP menekankan perlunya desain keamanan sistem, bukan mengandalkan satu prompt larangan.
Catatan implementasi dan pengujian tambahan
Untuk organisasi kecil, langkah awal dapat berupa memisahkan bot yang hanya membaca dari bot yang dapat mengubah sistem. Jalankan agen pertama pada dokumen uji yang mengandung instruksi palsu, lalu periksa apakah sistem menolaknya tanpa membocorkan data. Batasi konektor yang dapat mengirim ke alamat baru dan pastikan admin mendapat log percobaan tidak sah. Jangan menyimpan kata sandi dalam prompt; gunakan secret manager dan token dengan masa hidup pendek. Ketika sebuah insiden terjadi, cabut kredensial dan hentikan workflow sebelum melakukan investigasi lebih rinci. Dokumentasikan siapa memutuskan membuka kembali layanan dan bukti uji setelah perbaikan. Dengan demikian keamanan agentic AI menjadi disiplin operasional, bukan sekadar tanggung jawab penulis prompt.



Leave a Reply